阅读语言:English · Español · Русский · 中文 · Português
智能的标价一路走低,但菜单却越来越长。截至 2026 年 9 月中旬,OpenAI、Anthropic 和 Google 三家合计上架了两打以上的在售模型,每一款都有自己的单 token 费率、缓存折扣和长上下文附加费。本追踪把当前公布的标价汇总到一处、绘成图表,并解释究竟是什么在左右你的账单。下文的每一个数字都是以美元计、按每百万 token 计的标准短上下文标价,并已在 2026 年 9 月 13 日与各服务商自家的定价页面以及两个独立的价格追踪器交叉核对。
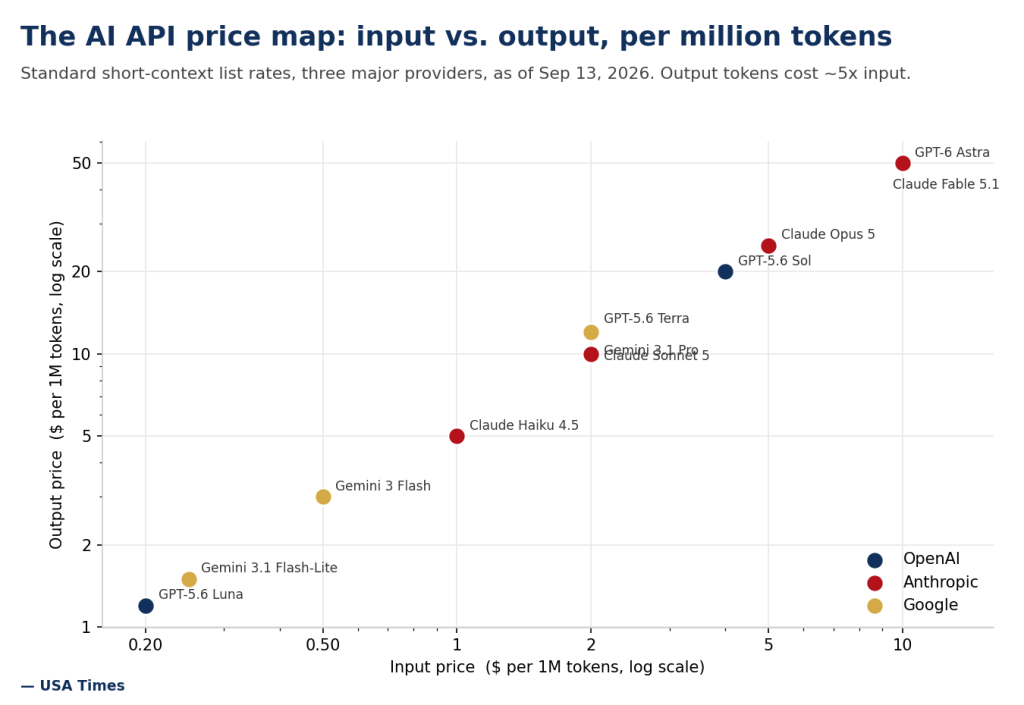
唯一要紧的数字:输出 token
翻开任何一张定价页,你都会看到每款模型的两个头条数字:输入(你发送的 token)和输出(模型生成的 token)。在几乎所有当前模型上,输出的费用大约是输入的五倍。在做预算之前,这个比例是你最需要牢记的一件事。一个读完长文档只用一句话作答的聊天机器人很便宜;而一个写出数千行代码的智能体,或一个产出长篇结构化内容的摘要器,才是钱花掉的地方。在上方的图表里,每款模型基本都落在同一条对角线上——各家服务商不仅在价格水平上趋同,连输入与输出之间的比例本身也趋同了。
Batmandir · The Circle Full access to theatres, museums & exhibitions. S2 · ongoing membership, without a Founder’s seat. Explore membership →当前的价目表
以下是多数团队真正会用到的模型的标准短上下文标价,按档位分组。价格以每百万 token 计。
| 模型 | 服务商 | 档位 | 输入 $/1M | 缓存输入 $/1M | 输出 $/1M |
|---|---|---|---|---|---|
| GPT-6 Astra | OpenAI | 前沿 | $10.00 | $1.00 | $50.00 |
| Claude Fable 5.1 | Anthropic | 前沿 | $10.00 | $0.25 | $50.00 |
| Claude Opus 5 | Anthropic | 高端 | $5.00 | $0.50 | $25.00 |
| GPT-5.5 | OpenAI | 高端 | $5.00 | $0.50 | $30.00 |
| GPT-5.6 Sol | OpenAI | 旗舰(促销) | $4.00 | $0.40 | $20.00 |
| GPT-5.6 Terra | OpenAI | 中端 | $2.00 | $0.20 | $12.00 |
| Claude Sonnet 5 | Anthropic | 中端 | $2.00 | $0.20 | $10.00 |
| Gemini 3.1 Pro | 中端 | $2.00 | $0.20 | $12.00 | |
| Claude Haiku 4.5 | Anthropic | 经济 | $1.00 | $0.10 | $5.00 |
| Gemini 3 Flash | 经济 | $0.50 | $0.05 | $3.00 | |
| Gemini 3.1 Flash-Lite | 经济 | $0.25 | $0.025 | $1.50 | |
| GPT-5.6 Luna | OpenAI | 经济 | $0.20 | $0.02 | $1.20 |
前沿档位已悄然趋同
2026 年数据中最引人注目的一点,是三家顶尖实验室在最高端之间几乎已无差距。OpenAI 的 GPT-6 Astra 与 Anthropic 的 Claude Fable 5.1 都标着完全相同的 $10 输入 / $50 输出的头条价。往下一档,OpenAI 的 GPT-5.5($5/$30)与 Anthropic 的 Claude Opus 5($5/$25)并列——输入相同,Anthropic 在输出上便宜 17%。在中端档,Claude Sonnet 5、GPT-5.6 Terra 和 Gemini 3.1 Pro 都锚定在 $2 输入,输出介于 $10 到 $12 之间。当标价如此接近时,token 费率就不再是决定性因素。基准测试、延迟、工具调用的可靠性,以及每款模型完成一项工作需要多少次失败的智能体循环,对于把活儿干完的总成本来说,重要得多。
唯一真正的异类是 OpenAI 的 GPT-5.6 Sol,$4/$20。OpenAI 把这个费率标注为促销价,并在自家文档中承诺至少维持到 2026 年 11 月 21 日——此后就可能上调。如果你正围绕 Sol 做预算,请把它的价格当作临时的。
真正改变算式的折扣
标价是上限,不是账单。有三种机制经常能把实际成本砍掉一半甚至更多:
- 提示缓存。被复用的提示前缀——系统提示、工具定义、你每一轮都发送的参考文档——在三家服务商上都按标准输入费率的约 10% 计费。Anthropic 在这方面最激进:Fable 5.1 的缓存读取降到每百万 $0.25,相较其 $10 基准价打了 97.5% 的折扣。对于任何反复重发相同上下文的长期运行智能体,缓存就是可行产品与难以负担之间的分水岭。
- 批处理。OpenAI 和 Anthropic 都对可以容忍延迟的异步任务在输入和输出上直接打五折。把批处理叠加在缓存之上,一个工作负载可以按标价的约四分之一运行。
- 模型路由。最便宜的杠杆,就是不要事事都用旗舰模型。分类、抽取和路由,在经济档模型上跑得很好,其输出价格仅为前沿档的五十分之一。成熟的做法是默认使用中端或经济档模型,仅在有可衡量的质量差距时才升级。
头条价失效的地方
有两条脚注能让账单翻倍,而且很容易被忽略。第一,长上下文。OpenAI 当前的旗舰模型在请求超过 272,000 个输入 token 后会启用更高的计费表——对 GPT-5.6 系列而言,整个请求的输入大约翻倍、输出上涨 50%。Google 对 Gemini 3.1 Pro 在超过 200,000 token 时也有类似的跳档($2/$12 变为 $4/$18)。如果你的提示很长,定价页上那个短上下文的数字就不是你的数字。第二,处理档位。“Fast”或优先模式的费用是标准价的数倍;Batch 和 Flex 则只是其中的一小部分。每一次价格比较都应附上服务商和服务档位,否则它就毫无意义。
如何真正用好这份表
对多数团队来说,2026 年 9 月的合理默认选择是一款中端模型——Sonnet 5、Terra 或 Gemini 3.1 Pro——约 $2 输入、$10 到 $12 输出,开启缓存,并让更便宜的模型处理高频、低风险的调用。把 $50 输出的前沿档留给那些确实值得为更少失败尝试而付费的工作。而且由于这些价格逐月变动——Sol 的促销降价、Anthropic 把 Sonnet 5 的发布价永久化、Google 在四月取消免费 Pro 访问——请把你的预算锚定到一个带时间戳的快照,并在投入前重新核对。这里的数字是我们的,取自 2026 年 9 月 13 日。
USA Times 此前也追踪过 AI 热潮的成本一面,从用户报告高端模型上 token 消耗失控,到最终为这一切算力买单的资本支出指引,再到其下的电费账单。
我们的做法
我们记录了 OpenAI、Anthropic 和 Google 当前正式发布的模型在 2026 年 9 月 13 日的标准、公布、短上下文标价,涵盖输入、缓存输入和输出 token,以美元计、按每百万 token 计。凡遇服务商自家定价页面动态渲染之处,我们都把每个数字与两个引用相同服务商文档、且在同一周同步的独立价格追踪器交叉核对;我们只采用各来源一致的数字,并把受控访问、预览及专用(语音、实时、网络安全)模型排除在主表之外。价格变动频繁,并因云端经销商、区域和服务档位而异;请把这当作一个带时间戳的快照,而非实时报价。
- Anthropic — Claude API pricing
- OpenAI — pricing and developer API pricing docs
- Google — Gemini API pricing
- AI Pricing Guru — OpenAI / Anthropic / Google trackers (synced 2026-09-13)
- BenchLM — OpenAI API pricing registry (synced 2026-09-11)
译自英文原文。