Leer en: English · Español · Русский · 中文 · Português
El precio de lista de la inteligencia sigue cayendo, pero el menú se hace cada vez más largo. A mediados de septiembre de 2026, OpenAI, Anthropic y Google suman entre los tres más de dos docenas de modelos activos, cada uno con su propia tarifa por token, su descuento por caché y su recargo por contexto largo. Este rastreador reúne en un solo lugar los precios de lista vigentes, los grafica y explica qué es lo que de verdad mueve tu factura. Todas las cifras de abajo son tarifas de lista estándar, de contexto corto, en dólares estadounidenses por un millón de tokens, contrastadas con las propias páginas de precios de los proveedores y con dos rastreadores de precios independientes el 13 de septiembre de 2026.
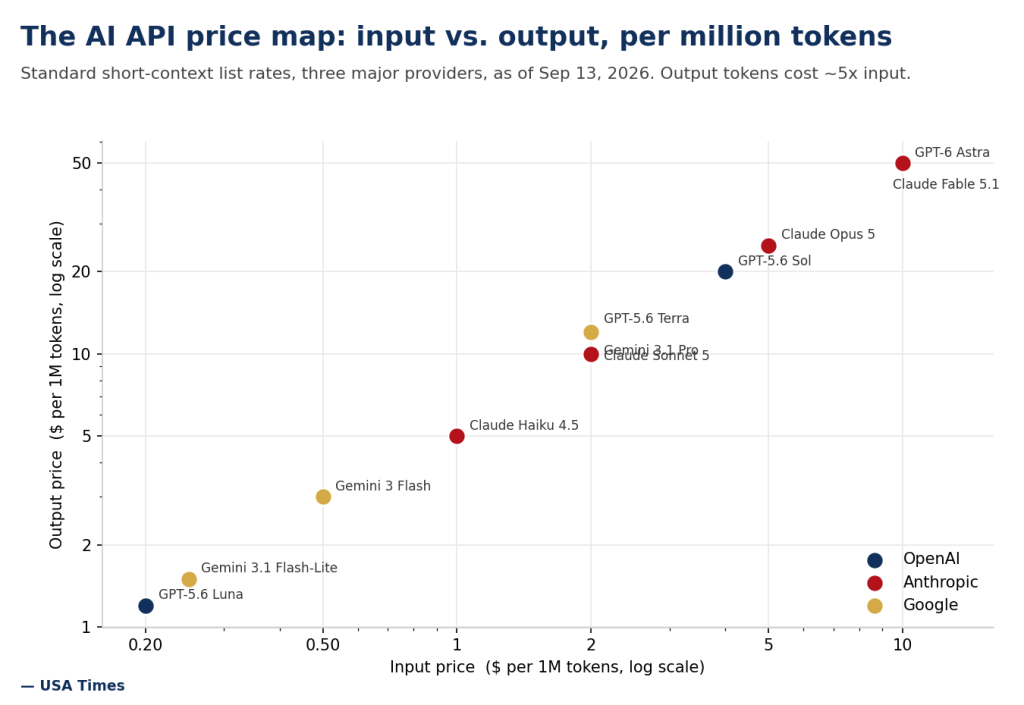
El único número que importa: los tokens de salida
Al leer una página de precios verás dos cifras principales por modelo: entrada (los tokens que envías) y salida (los tokens que el modelo genera). En casi todos los modelos actuales, la salida cuesta aproximadamente cinco veces más que la entrada. Esa proporción es lo más importante que hay que interiorizar antes de presupuestar. Un chatbot que lee un documento largo y responde en una sola frase es barato; un agente que escribe miles de líneas de código, o un resumidor que produce una salida larga y estructurada, es donde se va el dinero. En el gráfico de arriba, cada modelo se sitúa esencialmente sobre la misma línea diagonal: los proveedores han convergido no solo en los niveles de precio, sino en la propia proporción entre entrada y salida.
Batmandir · Founders A numbered seat at the table. S3 · The Founders Club — 161 seats per location. By invitation. Explore membership →La tarifa vigente
Estos son los precios de lista estándar de contexto corto para los modelos que la mayoría de los equipos usará de verdad, agrupados por nivel. Los precios son por un millón de tokens.
| Modelo | Proveedor | Nivel | Entrada $/1M | Entrada en caché $/1M | Salida $/1M |
|---|---|---|---|---|---|
| GPT-6 Astra | OpenAI | Frontera | $10.00 | $1.00 | $50.00 |
| Claude Fable 5.1 | Anthropic | Frontera | $10.00 | $0.25 | $50.00 |
| Claude Opus 5 | Anthropic | Premium | $5.00 | $0.50 | $25.00 |
| GPT-5.5 | OpenAI | Premium | $5.00 | $0.50 | $30.00 |
| GPT-5.6 Sol | OpenAI | Insignia (promo) | $4.00 | $0.40 | $20.00 |
| GPT-5.6 Terra | OpenAI | Medio | $2.00 | $0.20 | $12.00 |
| Claude Sonnet 5 | Anthropic | Medio | $2.00 | $0.20 | $10.00 |
| Gemini 3.1 Pro | Medio | $2.00 | $0.20 | $12.00 | |
| Claude Haiku 4.5 | Anthropic | Económico | $1.00 | $0.10 | $5.00 |
| Gemini 3 Flash | Económico | $0.50 | $0.05 | $3.00 | |
| Gemini 3.1 Flash-Lite | Económico | $0.25 | $0.025 | $1.50 | |
| GPT-5.6 Luna | OpenAI | Económico | $0.20 | $0.02 | $1.20 |
El nivel de frontera ha convergido en silencio
Lo más llamativo de los datos de 2026 es lo poca distancia que queda entre los tres laboratorios en la cima. El GPT-6 Astra de OpenAI y el Claude Fable 5.1 de Anthropic llevan un titular idéntico de $10 de entrada / $50 de salida. Un peldaño más abajo, el GPT-5.5 de OpenAI ($5/$30) se sitúa junto al Claude Opus 5 de Anthropic ($5/$25): la misma entrada, con Anthropic un 17% más barato en salida. En el nivel medio, Claude Sonnet 5, GPT-5.6 Terra y Gemini 3.1 Pro se anclan todos en $2 de entrada, con una salida de entre $10 y $12. Cuando los precios de lista están así de cerca, la tarifa por token deja de ser el factor decisivo. Los benchmarks, la latencia, la fiabilidad en el uso de herramientas y cuántos ciclos de agente fallidos necesita cada modelo para terminar un trabajo pesan mucho más en el costo total de sacar el trabajo adelante.
El único valor verdaderamente atípico es el GPT-5.6 Sol de OpenAI, a $4/$20. OpenAI califica esa tarifa de promocional y, en su propia documentación, se compromete a mantenerla disponible al menos hasta el 21 de noviembre de 2026, después de lo cual podría subir. Si estás armando un presupuesto en torno a Sol, trata su precio como temporal.
Los descuentos que de verdad cambian las cuentas
El precio de lista es el techo, no la factura. Tres mecanismos suelen recortar los costos reales a la mitad o más:
- Caché de prompts. Los prefijos de prompt reutilizados —prompts de sistema, definiciones de herramientas, un documento de referencia que envías en cada turno— se facturan a alrededor del 10% de la tarifa de entrada estándar en los tres proveedores. Anthropic es el más agresivo aquí: las lecturas de caché de Fable 5.1 bajaron a $0.25 por millón, un descuento del 97.5% sobre su base de $10. Para cualquier agente de larga duración que reenvía el mismo contexto una y otra vez, la caché es la diferencia entre un producto viable y uno inasequible.
- Procesamiento por lotes (batch). Tanto OpenAI como Anthropic aplican un 50% plano de descuento sobre entrada y salida en los trabajos asíncronos que pueden tolerar una demora. Combina el batch con la caché y una carga de trabajo puede correr a aproximadamente una cuarta parte del precio de lista.
- Enrutamiento de modelos. La palanca más barata es sencillamente no usar el modelo insignia para todo. La clasificación, la extracción y el enrutamiento funcionan bien en un modelo económico a una cincuentava parte del precio de salida del nivel de frontera. El patrón maduro es usar por defecto un modelo medio o económico y escalar solo cuando haya una brecha de calidad medida.
Dónde deja de aplicar el precio titular
Dos notas al pie pueden duplicar una factura y es fácil pasarlas por alto. Primero, el contexto largo. Los modelos insignia actuales de OpenAI cobran un contador más alto una vez que una solicitud supera los 272,000 tokens de entrada: para la familia GPT-5.6, la entrada prácticamente se duplica y la salida sube un 50% para toda la solicitud. Google aplica un escalón similar en Gemini 3.1 Pro por encima de los 200,000 tokens ($2/$12 pasa a $4/$18). Si tus prompts son largos, el número de contexto corto de la página de precios no es tu número. Segundo, los niveles de procesamiento. Los modos “rápido” o prioritario cuestan un múltiplo del estándar; Batch y Flex cuestan una fracción. Toda comparación de precios debería llevar adjunto el proveedor y el nivel de servicio, o carece de sentido.
Cómo usar esto en la práctica
Para la mayoría de los equipos, la opción sensata por defecto en septiembre de 2026 es un modelo de nivel medio —Sonnet 5, Terra o Gemini 3.1 Pro— en torno a $2 de entrada y de $10 a $12 de salida, con la caché activada y un modelo más barato encargándose de las llamadas de alto volumen y bajo riesgo. Reserva el nivel de frontera de $50 de salida para el trabajo en el que menos intentos fallidos justifiquen de verdad la tarifa. Y como estos precios se mueven de mes a mes —el recorte promocional de Sol, Anthropic haciendo permanente la tarifa de lanzamiento de Sonnet 5, la eliminación en abril por parte de Google del acceso gratuito a Pro—, ancla tu presupuesto a una instantánea fechada y vuelve a comprobarlo antes de comprometerte. Las cifras de aquí son nuestras, tomadas el 13 de septiembre de 2026.
USA Times ya ha seguido antes el lado de los costos del auge de la IA, desde usuarios que reportan un consumo desbocado de tokens en modelos premium hasta la orientación de gasto de capital que en última instancia paga toda esta capacidad de cómputo, y las facturas de electricidad que hay por debajo.
Qué hicimos
Registramos el precio de lista estándar, publicado y de contexto corto para los tokens de entrada, de entrada en caché y de salida de los modelos actualmente disponibles de forma general de OpenAI, Anthropic y Google, en dólares estadounidenses por un millón de tokens, el 13 de septiembre de 2026. Cuando la propia página de precios de un proveedor se generaba de forma dinámica, contrastamos cada cifra con dos rastreadores de precios independientes que citan la misma documentación del proveedor y que se sincronizaron esa misma semana; usamos solo los números en los que las fuentes coincidían, y excluimos de la tabla principal los modelos de acceso controlado, en vista previa y especializados (voz, tiempo real, ciberseguridad). Los precios cambian con frecuencia y varían según el revendedor en la nube, la región y el nivel de servicio; trata esto como una instantánea fechada, no como una cotización en vivo.
- Anthropic — precios de la API de Claude
- OpenAI — precios y documentación de precios de la API para desarrolladores
- Google — precios de la API de Gemini
- AI Pricing Guru — rastreadores de OpenAI / Anthropic / Google (sincronizados el 2026-09-13)
- BenchLM — registro de precios de la API de OpenAI (sincronizado el 2026-09-11)
Traducido del original en inglés.