Leer en: English · Español · Русский · 中文 · Português
El argumento a favor de ejecutar tu propia IA es seductor: sin factura por token, sin filtros de contenido que no hayas escrito tú, y tus datos nunca salen del edificio. La realidad en septiembre de 2026 es que el hardware para hacerlo bien se ha encarecido de forma drástica durante el último año, impulsado por una escasez de memoria que ha subido los precios de las GPU profesionales casi un 90% desde su lanzamiento. Esta guía expone tres niveles de montaje honestos a precios de calle vigentes, lo que cada uno puede ejecutar de verdad y —igual de importante— lo que la autoalojación no soluciona. Los precios de aquí se contrastaron con anuncios de tiendas y de mercados en línea el 13 de septiembre de 2026.
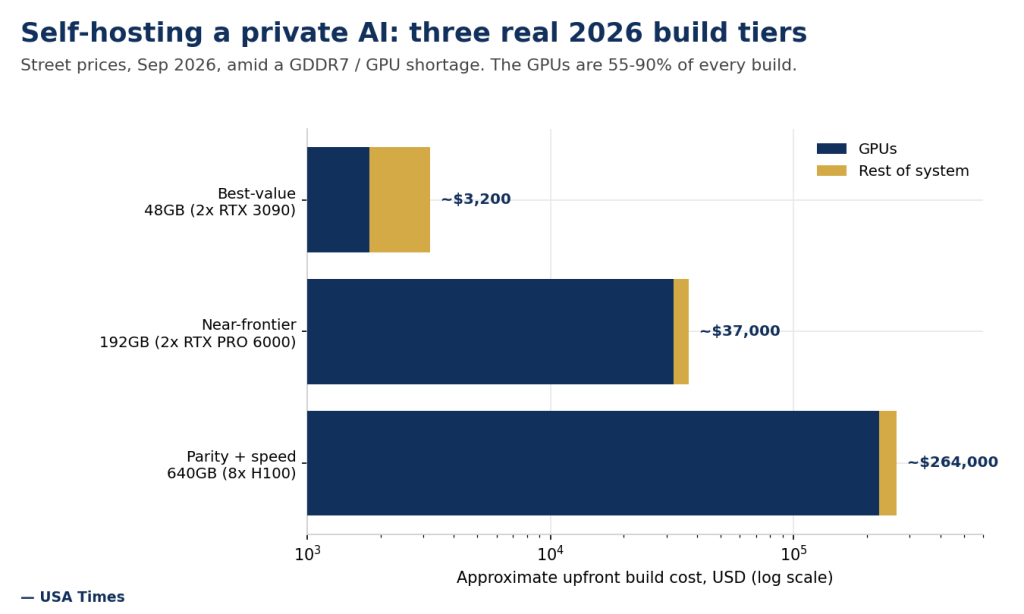
Antes de los niveles, un número que conviene tener presente: la GPU es el montaje. En el equipo de entrada las tarjetas gráficas son algo más de la mitad del total; en los dos montajes mayores son entre 85 y 90 centavos de cada dólar. Todo lo demás —CPU, placa, RAM, alimentación, refrigeración— es un error de redondeo en comparación. Eso significa que tu decisión es en realidad una decisión sobre qué GPU, y cuántas.
Batmandir · Founders A numbered seat at the table. S3 · The Founders Club — 161 seats per location. By invitation. Explore membership →Nivel 1 — La mejor relación calidad-precio, ~$3,000–3,500 (48GB de VRAM)
Dos RTX 3090 usadas siguen siendo el rey en relación calidad-precio de la IA local. Cada tarjeta de 24GB cuesta aproximadamente entre $700 y $1,050 en el mercado de segunda mano a septiembre de 2026, lo que te da 48GB de VRAM combinada por unos $1,800. Combínalas con una CPU convencional de 12 núcleos, una placa con el espaciado PCIe adecuado, 128GB de RAM de sistema, un disco NVMe de 2TB y una robusta fuente de alimentación de 1,300–1,500W, y toda la máquina se queda en torno a $3,200. Consume unos 700W bajo carga, así que dale su propio circuito de 15–20A y separa las tarjetas para que no sufran limitación térmica.
Qué ejecuta: modelos abiertos de la clase de 70 mil millones de parámetros —las familias Llama y Qwen de 70–72B— cuantizados a 4 bits, con una calidad genuinamente útil. Es un asistente privado capaz para redactar, resumir y ayudar con la programación diaria. Donde flojea es en el trabajo agéntico largo de varios pasos y en la automatización del navegador, donde los modelos abiertos todavía van por detrás de la frontera.
Nivel 2 — Casi frontera, ~$32,000–37,000 (192GB de VRAM)
Este es el nivel al que más ha golpeado la escasez de GPU de 2026, y donde nuestras cifras más se apartan de las guías escritas incluso hace unos meses. La tarjeta que lo hace posible es la RTX PRO 6000 Blackwell de NVIDIA, con 96GB de GDDR7 cada una. Se lanzó en marzo de 2025 con un precio recomendado de $8,565. A septiembre de 2026, el propio mercado en línea de NVIDIA la anuncia a $16,000 —un aumento del 87%—, con Newegg y B&H ambos en torno a $15,999 y los anuncios de segunda mano aún más altos. El detonante es una escasez de memoria GDDR7 sin alivio a corto plazo; el diseño de 96GB en “clamshell” de la tarjeta la hace muy sensible al suministro de memoria.
Dos de esas tarjetas (192GB en total) cuestan ahora unos $32,000 por sí solas. Añade una plataforma de estación de trabajo de clase Threadripper, 256GB de RAM ECC, almacenamiento rápido y una fuente de la clase de 2,000W y el montaje se queda cerca de $37,000 —notablemente por encima de los “~$30k” que este nivel solía costar. Una nota de ahorro que sacó a la luz nuestra investigación: la variante Max-Q de 300W de la misma tarjeta se ha anunciado en torno a $8,300, y NVIDIA dice que el rendimiento en IA es prácticamente idéntico al de la versión de 600W, así que un montaje de dos tarjetas Max-Q puede devolver el nivel hacia los $20,000 bajos mientras funciona más fresco en un chasis multi-GPU.
Qué ejecuta: los modelos abiertos casi de frontera —Qwen3-235B, DeepSeek-R1, GLM— con calidad real en 4 bits. Es lo más parecido de forma realista al tipo de trabajo agéntico que hacen los modelos comerciales de frontera, en una sola caja. El consumo es de 1.3–1.5kW bajo carga; necesita una sala ventilada e, idealmente, un circuito dedicado de 20A.
Nivel 3 — Paridad y velocidad, ~$250,000+ (640GB de VRAM)
Un servidor de ocho H100 es el nivel de “ejecuta cualquier cosa, rápido, para muchos usuarios”. Las tarjetas H100 80GB nuevas cuestan aproximadamente entre $25,000 y $31,000 cada una, así que ocho de ellas rondan los $224,000 antes de sumar el chasis del servidor, las CPU, la red de alta velocidad y la malla NVLink que las hacen valer la pena; digamos entre $250,000 y $320,000 en total. Para una sola redacción o un equipo pequeño esto es excesivo; su verdadera justificación es el alto rendimiento entre muchos usuarios simultáneos, algo que la mayoría de quienes autoalojan no necesitan.
| Nivel | GPU | VRAM | Inversión inicial (sep. 2026) | Ejecuta bien |
|---|---|---|---|---|
| Mejor valor | 2x RTX 3090 usadas | 48GB | ~$3,200 | Modelos abiertos de clase 70B (Q4) |
| Casi frontera | 2x RTX PRO 6000 96GB | 192GB | ~$32,000–37,000 | Qwen3-235B / DeepSeek-R1 / GLM |
| Paridad + velocidad | 8x H100 80GB | 640GB | ~$250,000–320,000 | Cualquier cosa, alto rendimiento |
Alquilar es ahora la opción honesta por defecto para los niveles grandes
La otra cara de la inflación del hardware es que las tarifas de alquiler en la nube se han mantenido comparativamente estables. Una RTX PRO 6000 se alquila por aproximadamente $1.57 a $5.50 por GPU-hora según el proveedor; una H100 se consigue en torno a $3.20 por hora. A esas tarifas, una tarjeta de $16,000 equivale a muchos miles de horas de alquiler, y alquilar no conlleva depreciación, ni mantenimiento, ni exposición al próximo repunte del precio de la memoria. Para cualquier cosa por encima del nivel de entrada, las cuentas de comprar frente a alquilar en 2026 favorecen cada vez más el alquiler, salvo que estés usando el hardware de forma casi continua o que tus requisitos de privacidad de datos prohíban la nube por completo. Ese requisito de privacidad es, para muchos de quienes autoalojan, la razón de ser de todo, lo cual es un motivo legítimo para comprar incluso cuando la hoja de cálculo dice que alquiles.
La pila de software es la misma para todos los montajes
Independientemente del nivel, la receta es consistente: Ubuntu 24.04 LTS con los controladores de NVIDIA y CUDA actuales; un servidor de inferencia (vLLM por velocidad y por una API compatible con OpenAI, u Ollama por simplicidad); Open WebUI como interfaz al estilo de ChatGPT; y los modelos descargados en 4 bits para caber en la VRAM. El verdadero costo oculto no es la GPU, es la capa de agente. El uso de herramientas, el control del navegador y la fontanería de conectores que vienen integrados en los asistentes comerciales hay que reconstruirlos por cuenta propia con un marco de agentes conectado a tu API. Presupuesta días, no horas, para eso.
Qué soluciona la autoalojación, y qué no
Soluciona de verdad tres cosas: ninguna lista de contenido prohibido que no hayas escrito tú, privacidad y control totales de los datos, y cero costo por token una vez amortizado el hardware. No soluciona la automatización de redes sociales (Reddit, X y LinkedIn bloquean los bots por su lado, no por el del modelo), no desbloquea las suscripciones SaaS restringidas, y no cierra la brecha de calidad en las tareas de agente largas y de varios pasos, donde los modelos abiertos todavía van por detrás de la frontera. Y no hay tiempo de actividad gestionado: si se cae a las 2 de la madrugada, es cosa tuya. Para el lado del costo por token del asunto —lo que de verdad estás ahorrando por millón de tokens— consulta nuestro rastreador de costos de modelos de IA. La electricidad que hay por debajo de todo esto es una partida aparte, y desglosamos el costo de funcionamiento del primer año de un equipo doméstico en un artículo complementario.
Qué hicimos
Montamos tres configuraciones de referencia en los rangos de precio que se citan habitualmente para la IA privada, y luego cotizamos los componentes que soportan el peso —las GPU— frente a anuncios en vivo de tiendas y mercados en línea el 13 de septiembre de 2026, y estimamos el resto del sistema a partir de piezas estándar de estación de trabajo y de servidor. Los precios de las GPU durante una escasez de memoria son volátiles y varían según el día, la tienda y el estado; los totales son aproximados y redondeados, y deberían volver a comprobarse antes de la compra. Las tarifas de alquiler citadas son precios de lista bajo demanda de los proveedores de la misma semana.
- Thunder Compute — precios de la RTX PRO 6000 Blackwell y tarifas de alquiler en la nube (sep. 2026)
- Tom’s Hardware — aumento del precio recomendado de la RTX PRO 6000 a $16,000
- XDA — la RTX 3090 usada sigue siendo el rey de la relación calidad-precio para la IA local
- CloudZero — el costo de la NVIDIA H100 en 2026
Traducido del original en inglés.