Ler em: English · Español · Русский · 中文 · Português
O argumento para rodar sua própria IA é sedutor: nenhuma conta por token, nenhum filtro de conteúdo que você não escreveu, e seus dados nunca saem do prédio. A realidade, em setembro de 2026, é que o hardware para fazer isso bem ficou drasticamente mais caro ao longo do último ano, impulsionado por uma escassez de memória que empurrou os preços das GPUs profissionais para cima em quase 90% desde o lançamento. Este guia apresenta três camadas honestas de montagem aos preços de mercado atuais, o que cada uma consegue de fato rodar e — igualmente importante — o que a hospedagem própria não resolve. Os preços aqui foram verificados contra anúncios de varejistas e marketplaces em 13 de setembro de 2026.
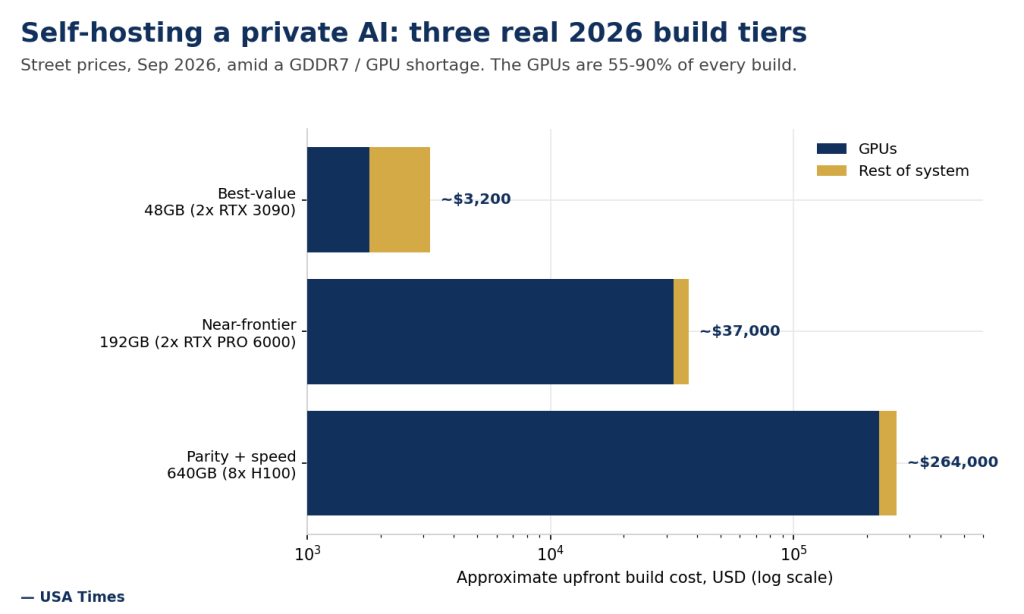
Antes das camadas, um número para ter em mente: a GPU é a montagem. Na configuração de entrada, as placas de vídeo são pouco mais da metade do total; nas duas montagens maiores, elas são 85 a 90 centavos de cada dólar. Todo o resto — CPU, placa-mãe, RAM, energia, refrigeração — é um arredondamento por comparação. Isso significa que sua decisão é, na verdade, uma decisão sobre quais GPUs, e quantas.
Batmandir · Founders A numbered seat at the table. S3 · The Founders Club — 161 seats per location. By invitation. Explore membership →Camada 1 — Melhor custo-benefício, ~$3.000–3.500 (48GB de VRAM)
Duas RTX 3090 usadas continuam sendo o rei do custo-benefício em IA local. Cada placa de 24GB custa cerca de $700 a $1.050 no mercado de usados em setembro de 2026, dando a você 48GB de VRAM combinada por cerca de $1.800. Combine-as com uma CPU convencional de 12 núcleos, uma placa-mãe com espaçamento PCIe adequado, 128GB de RAM de sistema, um SSD NVMe de 2TB e uma fonte robusta de 1.300–1.500W, e a máquina inteira fica em torno de $3.200. Ela consome cerca de 700W sob carga, então dê a ela um circuito próprio de 15–20A e espace as placas para que não sofram thermal throttling.
O que ela roda: modelos abertos da classe de 70 bilhões de parâmetros — as famílias Llama e Qwen de 70–72B — quantizados em 4 bits, com qualidade genuinamente útil. Este é um assistente privado capaz para redigir, resumir e ajudar na programação do dia a dia. Onde ela tem dificuldade é em trabalho agêntico longo e de múltiplas etapas e em automação de navegador, onde os modelos abertos ainda ficam atrás da fronteira.
Camada 2 — Quase fronteira, ~$32.000–37.000 (192GB de VRAM)
Esta é a camada que a escassez de GPUs de 2026 atingiu com mais força, e onde nossos números mais divergem de guias escritos há apenas alguns meses. A placa que a torna viável é a RTX PRO 6000 Blackwell da NVIDIA, com 96GB de GDDR7 cada. Ela foi lançada em março de 2025 com um MSRP de $8.565. Em setembro de 2026, o próprio marketplace da NVIDIA a anuncia a $16.000 — um aumento de 87% — com Newegg e B&H ambas a cerca de $15.999 e anúncios de usados chegando ainda mais alto. O motor disso é uma escassez de memória GDDR7 sem alívio no curto prazo; o design clamshell de 96GB da placa a torna extremamente sensível ao fornecimento de memória.
Duas dessas placas (192GB no total) custam agora cerca de $32.000 sozinhas. Adicione uma plataforma de workstation classe Threadripper, 256GB de RAM ECC, armazenamento rápido e uma fonte da classe 2.000W, e a montagem fica perto de $37.000 — visivelmente acima dos “~$30 mil” que essa camada costumava custar. Uma nota que economiza dinheiro e que nossa apuração encontrou: a variante Max-Q de 300W da mesma placa vem sendo anunciada em torno de $8.300, e a NVIDIA diz que o desempenho em IA é praticamente idêntico ao da versão de 600W, então uma montagem de duas placas Max-Q pode trazer a camada de volta para a casa dos $20 mil e poucos, rodando mais fria em um chassi multi-GPU.
O que ela roda: os modelos abertos quase de fronteira — Qwen3-235B, DeepSeek-R1, GLM — com qualidade real em 4 bits. Esta é a correspondência realista mais próxima do tipo de trabalho agêntico que os modelos comerciais de fronteira fazem, em uma única máquina. O consumo é de 1,3–1,5kW sob carga; ela precisa de uma sala ventilada e, idealmente, de um circuito dedicado de 20A.
Camada 3 — Paridade e velocidade, ~$250.000+ (640GB de VRAM)
Um servidor de oito H100 é a camada do “rode qualquer coisa, rápido, para muitos usuários”. Placas H100 80GB novas custam cerca de $25.000 a $31.000 cada, então oito delas ficam em torno de $224.000 antes de adicionar o chassi do servidor, as CPUs, a rede de alta velocidade e o tecido NVLink que as tornam dignas de se ter — digamos $250.000 a $320.000 no total. Para uma única redação ou equipe pequena, isso é exagero; sua verdadeira justificativa é a alta vazão entre muitos usuários simultâneos, que a maioria de quem hospeda em casa não precisa.
| Camada | GPUs | VRAM | Custo inicial (set. 2026) | Roda bem |
|---|---|---|---|---|
| Melhor custo-benefício | 2x RTX 3090 usada | 48GB | ~$3.200 | Modelos abertos classe 70B (Q4) |
| Quase fronteira | 2x RTX PRO 6000 96GB | 192GB | ~$32.000–37.000 | Qwen3-235B / DeepSeek-R1 / GLM |
| Paridade + velocidade | 8x H100 80GB | 640GB | ~$250.000–320.000 | Qualquer coisa, alta vazão |
Alugar agora é o padrão honesto para as camadas maiores
O outro lado da inflação do hardware é que as tarifas de aluguel na nuvem se mantiveram comparativamente estáveis. Uma RTX PRO 6000 é alugada por cerca de $1,57 a $5,50 por GPU-hora, dependendo do provedor; uma H100 pode ser conseguida em torno de $3,20 por hora. A essas tarifas, uma placa de $16.000 equivale a muitos milhares de horas de aluguel — e alugar não tem depreciação, nem manutenção, nem exposição ao próximo pico de preço da memória. Para qualquer coisa acima da camada de entrada, a conta de comprar versus alugar em 2026 favorece cada vez mais o aluguel, a menos que você rode o hardware quase continuamente ou que seus requisitos de privacidade de dados proíbam a nuvem por completo. Esse requisito de privacidade é, para muitos que hospedam em casa, todo o objetivo — o que é uma razão legítima para comprar mesmo quando a planilha diz para alugar.
A pilha de software é a mesma para toda montagem
Independentemente da camada, a receita é consistente: Ubuntu 24.04 LTS com drivers NVIDIA atuais e CUDA; um servidor de inferência (vLLM para velocidade e uma API compatível com a da OpenAI, ou Ollama para simplicidade); Open WebUI como interface no estilo ChatGPT; e modelos baixados em 4 bits para caber na VRAM. O verdadeiro custo oculto não é a GPU — é a camada de agente. O uso de ferramentas, o controle de navegador e o encanamento de conectores que já vêm embutidos nos assistentes comerciais têm de ser reconstruídos por você mesmo, com um framework de agente ligado à sua API. Reserve dias, não horas, para isso.
O que a hospedagem própria resolve — e o que não resolve
Ela resolve genuinamente três coisas: nenhuma lista de bloqueio de conteúdo que você não escreveu, privacidade e controle totais dos dados, e custo zero por token depois que o hardware está pago. Ela não resolve a automação de redes sociais (Reddit, X e LinkedIn bloqueiam bots no lado deles, não no do modelo), não desbloqueia assinaturas de SaaS restritas e não fecha a diferença de qualidade em tarefas de agente longas e de múltiplas etapas, onde os modelos abertos ainda ficam atrás da fronteira. E não há tempo de atividade gerenciado: se ela morrer às 2 da manhã, o problema é seu. Para o lado do custo por token da troca — o que você está de fato economizando por milhão de tokens — veja nosso monitor de custos de modelos de IA. A eletricidade por baixo de tudo isso é uma rubrica à parte, e detalhamos o custo de operação do primeiro ano de uma máquina caseira em uma matéria complementar.
O que fizemos
Montamos três configurações de referência nos pontos de preço comumente citados para IA privada, depois precificamos os componentes que sustentam a conta — as GPUs — contra anúncios ao vivo de varejistas e marketplaces em 13 de setembro de 2026, e estimamos o restante do sistema a partir de peças padrão de workstation e servidor. Os preços de GPU durante uma escassez de memória são voláteis e variam por dia, varejista e condição; os totais são aproximados e arredondados, e devem ser reverificados antes da compra. As tarifas de aluguel citadas são preços de tabela sob demanda dos provedores na mesma semana.
- Thunder Compute — preços da RTX PRO 6000 Blackwell e tarifas de aluguel na nuvem (set. 2026)
- Tom’s Hardware — aumento do MSRP da RTX PRO 6000 para $16.000
- XDA — a RTX 3090 usada segue como rei do custo-benefício para IA local
- CloudZero — o custo da NVIDIA H100 em 2026
Traduzido do original em inglês.