Ler em: English · Español · Русский · 中文 · Português
O preço de tabela da inteligência não para de cair, mas o cardápio só aumenta. Em meados de setembro de 2026, OpenAI, Anthropic e Google somam entre si mais de duas dúzias de modelos ativos, cada um com sua própria tarifa por token, desconto de cache e sobretaxa de contexto longo. Este monitor reúne os preços de tabela atuais em um só lugar, coloca-os em gráficos e explica o que de fato mexe na sua conta. Cada número abaixo é uma tarifa de tabela padrão, de contexto curto, em dólares americanos por um milhão de tokens, verificada contra as próprias páginas de preços dos provedores e dois monitores de preços independentes em 13 de setembro de 2026.
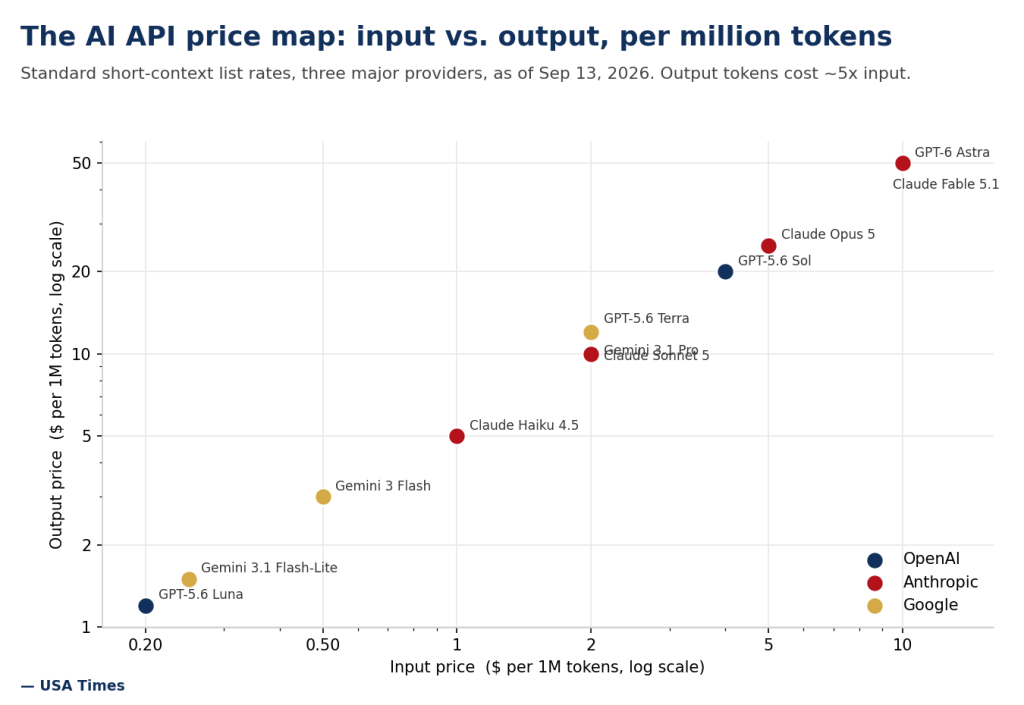
O único número que importa: os tokens de saída
Ao ler uma página de preços, você verá dois números de destaque por modelo: entrada (os tokens que você envia) e saída (os tokens que o modelo gera). Em quase todos os modelos atuais, a saída custa cerca de cinco vezes a entrada. Essa proporção é a coisa mais importante a internalizar antes de fazer o orçamento. Um chatbot que lê um documento longo e responde em uma frase é barato; um agente que escreve milhares de linhas de código, ou um resumidor que produz uma saída longa e estruturada, é onde o dinheiro vai embora. No gráfico acima, todos os modelos ficam essencialmente sobre a mesma linha diagonal — os provedores convergiram não só nos níveis de preço, mas na própria proporção entre entrada e saída.
Batmandir · Founders A numbered seat at the table. S3 · The Founders Club — 161 seats per location. By invitation. Explore membership →A tabela de tarifas atual
Aqui estão os preços de tabela padrão, de contexto curto, para os modelos que a maioria das equipes vai efetivamente usar, agrupados por camada. Os preços são por um milhão de tokens.
| Modelo | Provedor | Camada | Entrada $/1M | Entrada em cache $/1M | Saída $/1M |
|---|---|---|---|---|---|
| GPT-6 Astra | OpenAI | Frontier | $10.00 | $1.00 | $50.00 |
| Claude Fable 5.1 | Anthropic | Frontier | $10.00 | $0.25 | $50.00 |
| Claude Opus 5 | Anthropic | Premium | $5.00 | $0.50 | $25.00 |
| GPT-5.5 | OpenAI | Premium | $5.00 | $0.50 | $30.00 |
| GPT-5.6 Sol | OpenAI | Flagship (promo) | $4.00 | $0.40 | $20.00 |
| GPT-5.6 Terra | OpenAI | Mid | $2.00 | $0.20 | $12.00 |
| Claude Sonnet 5 | Anthropic | Mid | $2.00 | $0.20 | $10.00 |
| Gemini 3.1 Pro | Mid | $2.00 | $0.20 | $12.00 | |
| Claude Haiku 4.5 | Anthropic | Budget | $1.00 | $0.10 | $5.00 |
| Gemini 3 Flash | Budget | $0.50 | $0.05 | $3.00 | |
| Gemini 3.1 Flash-Lite | Budget | $0.25 | $0.025 | $1.50 | |
| GPT-5.6 Luna | OpenAI | Budget | $0.20 | $0.02 | $1.20 |
A camada frontier convergiu silenciosamente
O mais impressionante nos dados de 2026 é como sobrou pouca diferença entre os três laboratórios no topo. O GPT-6 Astra da OpenAI e o Claude Fable 5.1 da Anthropic trazem um valor de destaque idêntico de $10 na entrada / $50 na saída. Um degrau abaixo, o GPT-5.5 da OpenAI ($5/$30) fica ao lado do Claude Opus 5 da Anthropic ($5/$25) — mesma entrada, com a Anthropic 17% mais barata na saída. Na camada intermediária, o Claude Sonnet 5, o GPT-5.6 Terra e o Gemini 3.1 Pro se ancoram todos em $2 de entrada, com saída entre $10 e $12. Quando os preços de tabela estão tão próximos, a tarifa por token deixa de ser o fator decisivo. Benchmarks, latência, confiabilidade no uso de ferramentas e quantos loops de agente malsucedidos cada modelo precisa para concluir uma tarefa pesam muito mais no custo total de fazer o trabalho.
O único verdadeiro ponto fora da curva é o GPT-5.6 Sol da OpenAI, a $4/$20. A OpenAI rotula essa tarifa como promocional e, em sua própria documentação, compromete-se a mantê-la disponível pelo menos até 21 de novembro de 2026 — depois disso, ela pode subir. Se você está montando um orçamento em torno do Sol, trate seu preço como temporário.
Os descontos que de fato mudam a conta
O preço de tabela é o teto, não a conta. Três mecanismos reduzem rotineiramente os custos reais pela metade ou mais:
- Cache de prompt. Prefixos de prompt reutilizados — prompts de sistema, definições de ferramentas, um documento de referência que você envia a cada turno — são cobrados a cerca de 10% da tarifa de entrada padrão nos três provedores. A Anthropic é a mais agressiva aqui: as leituras de cache do Fable 5.1 caíram para $0.25 por milhão, um desconto de 97,5% sobre sua base de $10. Para qualquer agente de longa duração que reenvie o mesmo contexto repetidamente, o cache é a diferença entre um produto viável e um inviável.
- Processamento em lote (Batch). OpenAI e Anthropic dão ambas 50% de desconto fixo sobre entrada e saída para trabalhos assíncronos que toleram um atraso. Empilhe o batch sobre o cache e uma carga de trabalho pode rodar a cerca de um quarto do preço de tabela.
- Roteamento de modelos. A alavanca mais barata é simplesmente não usar o modelo topo de linha para tudo. Classificação, extração e roteamento rodam bem em um modelo econômico a um cinquentavo do preço de saída da camada frontier. O padrão maduro é usar por padrão um modelo intermediário ou econômico e escalar apenas diante de uma diferença de qualidade medida.
Onde o preço de destaque deixa de valer
Duas notas de rodapé podem dobrar uma conta e passam facilmente despercebidas. Primeiro, o contexto longo. Os modelos topo de linha atuais da OpenAI cobram um medidor mais alto assim que uma solicitação ultrapassa 272.000 tokens de entrada — para a família GPT-5.6, a entrada praticamente dobra e a saída sobe 50% para a solicitação inteira. O Google aplica um degrau semelhante no Gemini 3.1 Pro acima de 200.000 tokens ($2/$12 vira $4/$18). Se seus prompts são longos, o número de contexto curto da página de preços não é o seu número. Segundo, as camadas de processamento. Os modos “rápido” ou de prioridade custam um múltiplo do padrão; Batch e Flex custam uma fração. Toda comparação de preço deveria carregar o provedor e a camada de serviço junto, ou não significa nada.
Como de fato usar isto
Para a maioria das equipes, o padrão sensato em setembro de 2026 é um modelo de camada intermediária — Sonnet 5, Terra ou Gemini 3.1 Pro — em torno de $2 de entrada e $10 a $12 de saída, com o cache ligado e um modelo mais barato cuidando das chamadas de alto volume e baixo risco. Reserve a camada frontier de $50 de saída para trabalhos em que menos tentativas malsucedidas realmente justifiquem a tarifa. E como esses preços mudam de mês para mês — o corte promocional do Sol, a Anthropic tornando permanente a tarifa de lançamento do Sonnet 5, a remoção pelo Google do acesso gratuito ao Pro em abril — ancore seu orçamento a um instantâneo datado e reveja antes de se comprometer. Os números aqui são nossos, coletados em 13 de setembro de 2026.
O USA Times já acompanhou o lado dos custos do boom da IA antes, desde usuários relatando consumo descontrolado de tokens em modelos premium até a projeção de investimentos de capital que, no fim das contas, paga por toda essa computação, e as contas de eletricidade por baixo disso.
O que fizemos
Registramos o preço de tabela padrão, publicado e de contexto curto para tokens de entrada, entrada em cache e saída dos modelos atuais de disponibilidade geral da OpenAI, Anthropic e Google, em dólares americanos por um milhão de tokens, em 13 de setembro de 2026. Onde a própria página de preços de um provedor era renderizada dinamicamente, verificamos cada número contra dois monitores de preços independentes que citam a mesma documentação do provedor e foram sincronizados na mesma semana; usamos apenas números em que as fontes concordavam e excluímos da tabela principal os modelos de acesso controlado, prévia e especializados (voz, tempo real, cibersegurança). Os preços mudam com frequência e variam por revendedor de nuvem, região e camada de serviço; trate isto como um instantâneo datado, não como uma cotação ao vivo.
- Anthropic — preços da API Claude
- OpenAI — preços e documentação de preços da API para desenvolvedores
- Google — preços da API Gemini
- AI Pricing Guru — monitores OpenAI / Anthropic / Google (sincronizado em 2026-09-13)
- BenchLM — registro de preços da API OpenAI (sincronizado em 2026-09-11)
Traduzido do original em inglês.